Laya ve Jev: Yapay Zekada Karar Modelleri
Metin üretiminden yapılandırılmış kararlara: System One yaklaşımı, LangChain entegrasyonu ve kurumsal kullanım senaryoları
Bir müşteri talebini doğru ekibe yönlendirmek, bir belgenin yeterli bilgi içerip içermediğini değerlendirmek veya bir araç çağrısını incelemeye almak için her zaman uzun bir yanıt üretmek gerekmiyor. Kurumsal yazılım çoğu zaman daha dar bir sonuca ihtiyaç duyuyor: bir kategori, bir puan veya tanımlı bir koşulun gerçekleşme olasılığı.
Laya ve TypeSafe AI’ın Jev modeli, bu karar noktalarına odaklanan iki yaklaşım. Ortak hedefleri, doğal dildeki girdileri yazılımın doğrudan kullanabileceği yapılandırılmış sonuçlara dönüştürmek. Bu da yapay zeka mimarisinde ayrı bir soruyu öne çıkarıyor: Hangi adımlarda üretken bir modele, hangi adımlarda sınırlı seçenekler üzerinde çalışan bir karar modeline ihtiyaç var?
System One modelleri nasıl çalışıyor?
TypeSafe, System One yaklaşımını hızlı ve kapsamı belirli değerlendirmeler için konumlandırıyor. Girdi olarak bir durum verisi ve bu veriye ilişkin sorular sunuluyor. Durum verisi bir destek kaydı, e-posta, konuşma geçmişi veya JSON nesnesi olabiliyor. Çıktı ise serbest metin yerine yazılımın işleyebileceği tipli değerlerden oluşuyor.
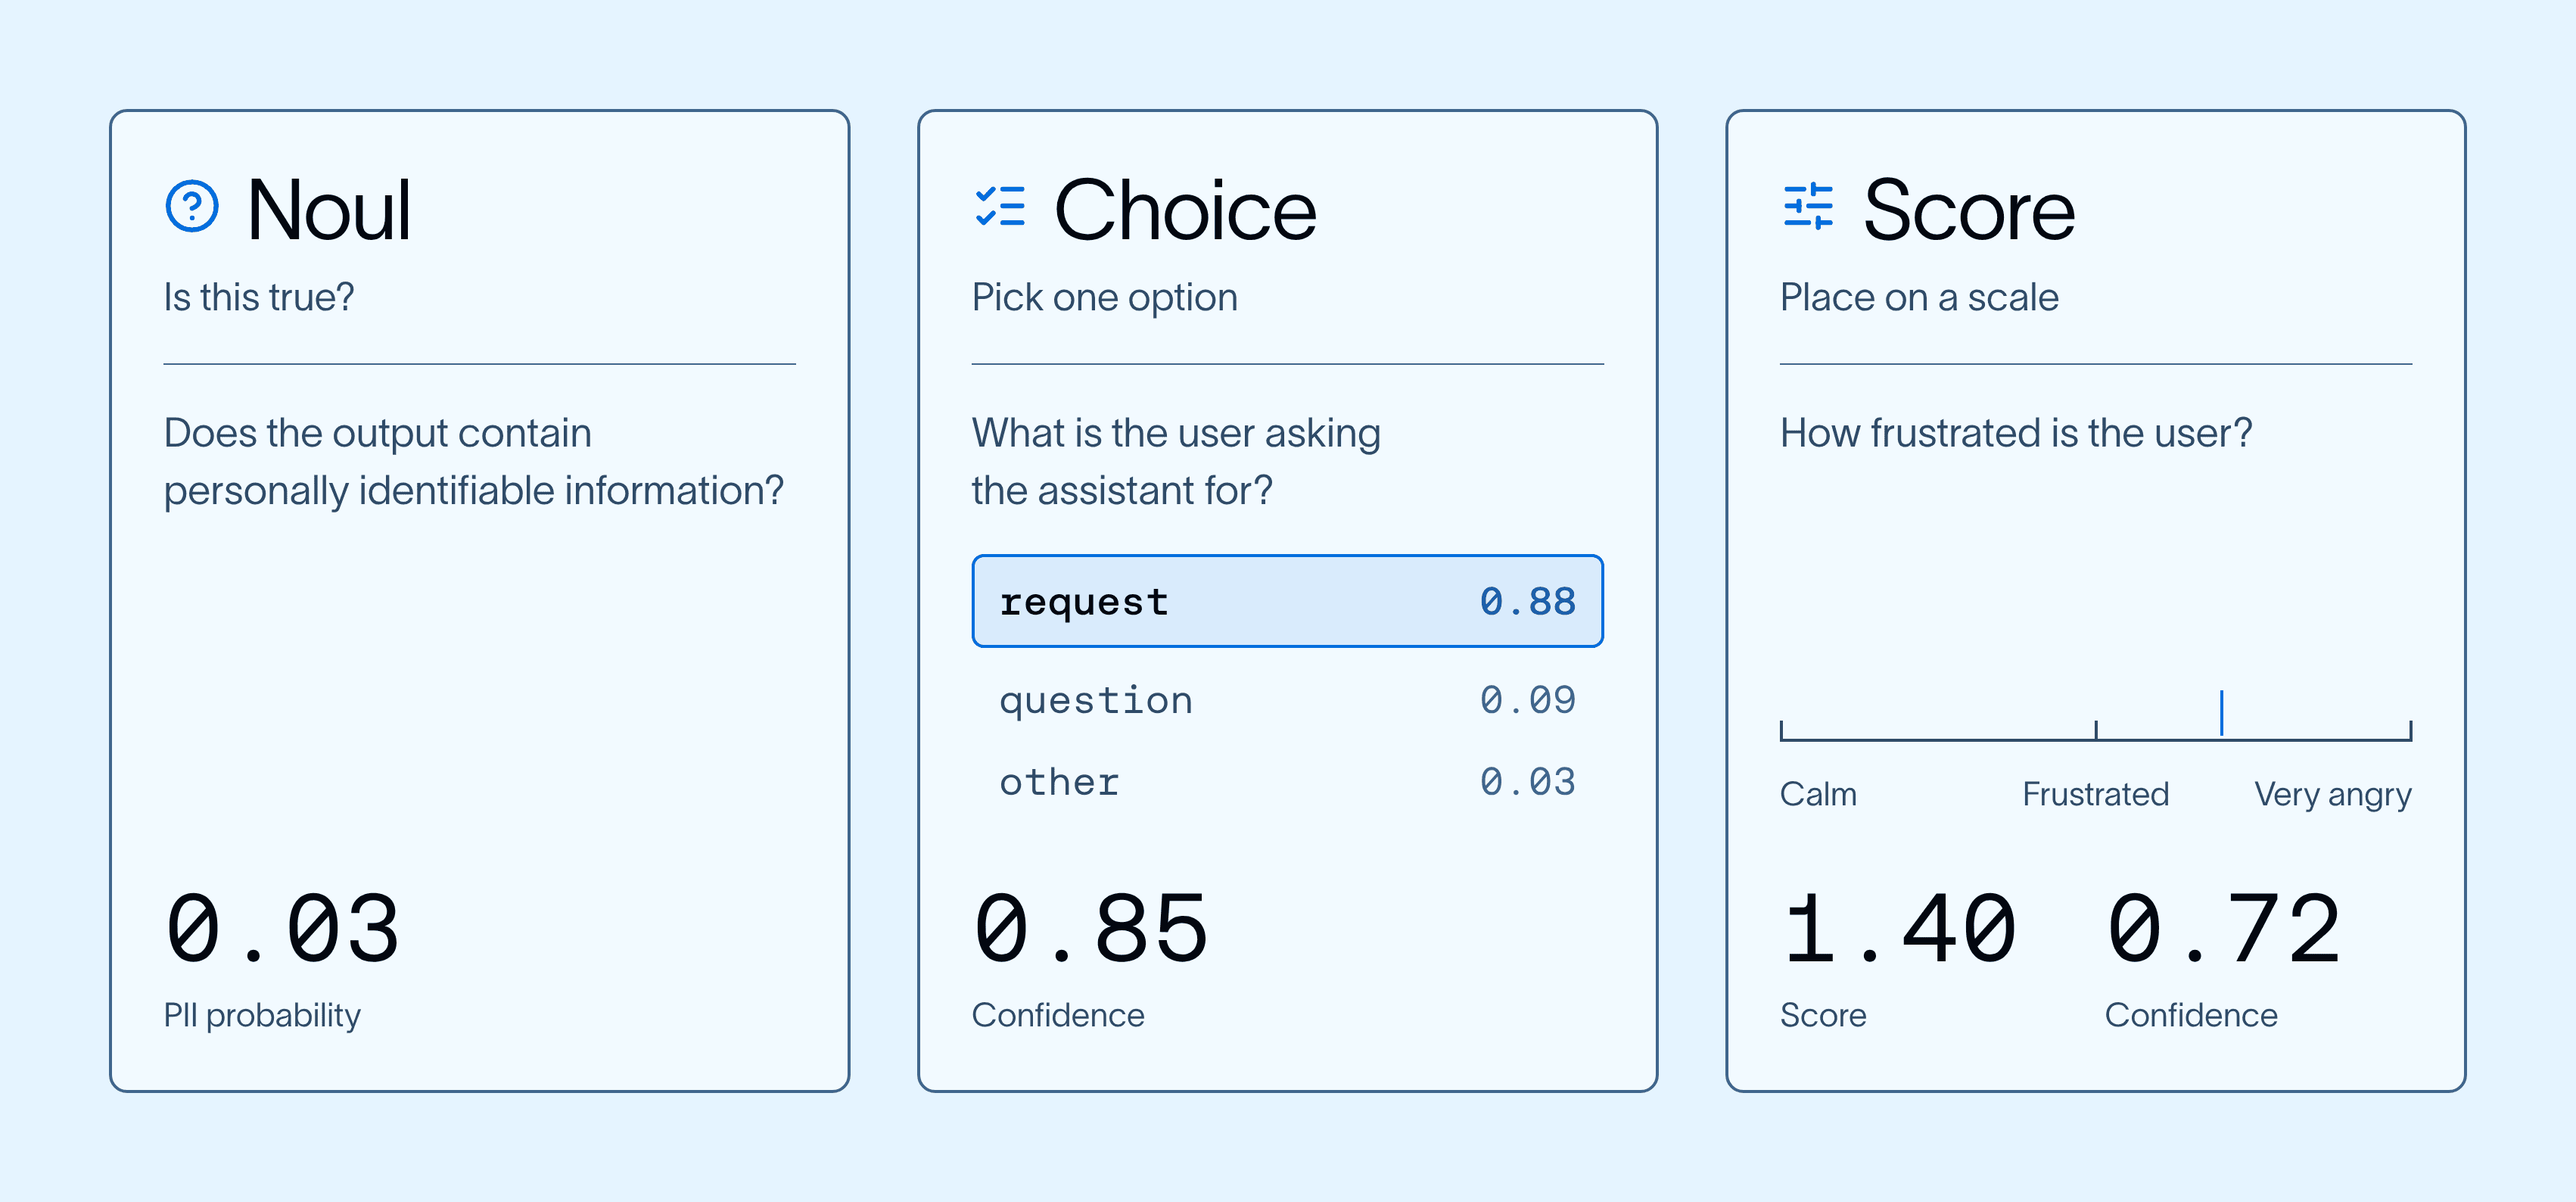
Jev’in arayüzü üç temel soru türü sunuyor:
| Soru türü | Ne yapar? | Örnek |
|---|---|---|
| Choice | Tanımlı seçenekler arasından seçim yapar. | Talep hangi ekibe yönlendirilmeli? |
| Score | Tanımlı bir değerlendirme ölçeğinde puan üretir. | Operasyonel etki hangi seviyede? |
| Noul | Bir önermenin doğru olma olasılığını döndürür. | Mesajda açıkça iade talebi var mı? |
Choice ve Score çıktıları olasılık dağılımları ve güven bilgisiyle birlikte sunulur. Noul ise 0–1 aralığında bir olasılıktır; 0,5 değeri “orta şiddet” değil, önermenin doğruluğu konusunda belirsizlik ifade eder. Birbirinden bağımsız sorular aynı durum verisi üzerinden birlikte değerlendirilebilir.
Örneğin, “Bu müşteriyle ne yapmalıyız?” gibi geniş bir soru yerine talebin türü, aciliyeti ve eksik bilgi içerip içermediği ayrı ayrı değerlendirilebilir. Sonraki işlem, bu sonuçları kullanan uygulama koduyla belirlenir. Böylece iş kuralları incelenebilir ve değiştirilebilir halde kalır.
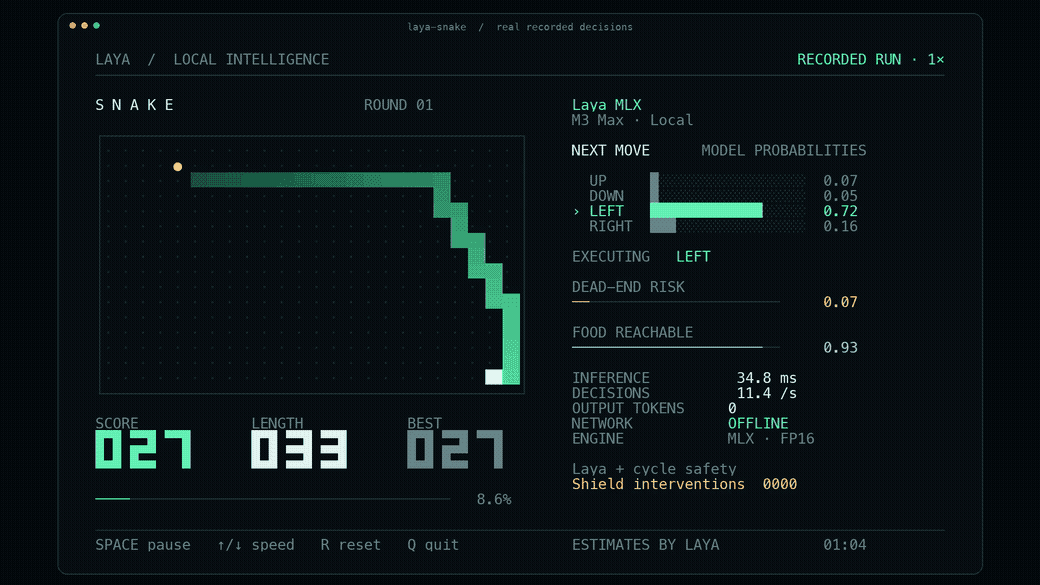
Kaynak: Laya-MLX runtime
Jev ve Laya arasındaki fark ne?
Jev, TypeSafe’ın API üzerinden sunduğu karar modelidir. Şirket, metni token token üretmek yerine yapılandırılmış çıktıları paralel hesaplamaya odaklanan bir mimari ve RLCD adını verdiği eğitim yaklaşımını açıklıyor. Bu yaklaşımın hedefi, kararlarla birlikte verilen olasılıkların doğrulukla daha tutarlı olmasıdır. Ancak modelin tüm iç mimarisinin açıklandığını varsaymamak gerekir.
Laya ise açık ağırlıkları ve Apache 2.0 lisansıyla yerel çalıştırma olanağı sunuyor. Model kartında İngilizce için ModernBERT, çok dilli kullanım için mmBERT tabanlı encoder yapıları açıklanıyor. Encoder, girdinin temsilini çıkarıyor; karar katmanı ise tanımlı seçenekleri puanlıyor. Serbest bir yanıt yazmak yerine seçenekler üzerinde olasılıklar hesaplanıyor.
Burada iki ayrı yönlendirme işlevini ayırmak önemli. Laya’nın kendi Router bileşeni, isteğin hangi model varyantında değerlendirileceğini seçiyor. Uygulamanın iş akışı yönlendiricisi ise modelden gelen sonuca göre hangi ekibin, aracın veya sürecin devreye gireceğini belirliyor. Birincisi model seçimi, ikincisi iş süreci yönetimidir.
| Boyut | Jev | Laya |
|---|---|---|
| Erişim | TypeSafe API ve SDK yaklaşımı | Açık ağırlıklarla yerel çalıştırma |
| Entegrasyon | Resmi LangChain entegrasyonu mevcut | Python SDK çağrısı özel bir düğüm veya servise alınabilir |
| Operasyon | API erişimi, veri aktarımı ve servis davranışı değerlendirilir | Donanım, model yükleme, ölçekleme ve izleme kurum tarafından yönetilir |
| Doğrulama | Kurumun verisinde karar kalitesi ölçülmelidir | Dil, model varyantı, görev uyumu ve kalibrasyon ayrıca ölçülmelidir |
Bu tablo bir üstünlük sıralaması değildir. Uygun tercih; verinin nerede işlenebileceğine, trafik yapısına ve ekibin modeli işletme kapasitesine bağlıdır.
Kaynak: Laya-MLX runtime
Sıfır halüsinasyon ne anlama geliyor?
Bu modelleri değerlendirirken en kritik ayrım, çıktı biçiminin doğruluğu ile kararın doğruluğu arasındadır.
TypeSafe’ın lansman yazısındaki sıfır hata ifadesi, şema uyumluluğu garantisine dayanıyor. Model yalnızca tanımlı seçenekleri döndürebiliyorsa listede bulunmayan bir araç adı üretmez. Ancak tanımlı seçenekler arasından yanlış olanı seçebilir.
Örneğin, bir talep yalnızca “faturalama”, “teknik destek” veya “diğer” olarak sınıflandırılabiliyorsa çıktı bu kümenin dışında olmayabilir. Buna rağmen teknik bir arıza yanlışlıkla faturalamaya yönlendirilebilir. Yazılım sonucu sorunsuz okuyabilir; iş kararı yine de hatalı olabilir.
Benzer biçimde, bir güven değerinin yüksek olması tek başına doğruluk garantisi değildir. Kalibrasyon, benzer olasılıklarla verilen kararların topluca ne sıklıkta doğru çıktığıyla ilgilidir. Bir görevde iyi kalibre edilen modelin farklı bir dilde veya veri dağılımında aynı davranışı göstereceği varsayılamaz.
Laya’nın model kartı da bu sınırı açıkça belirtiyor: temel varyantların bazı görevlerde sınırlı başarısı, aşırı güven sorunu ve alan verisiyle kalibrasyon ihtiyacı raporlanıyor. Ayrıca görev için ince ayar yapılmış bir varyantın başarısı, temel modelin her senaryoda aynı sonucu vereceği anlamına gelmiyor.
Dolayısıyla bu yaklaşım, karar adımındaki serbest metin üretimini ve şema dışı çıktı riskini azaltır. Bir RAG sistemindeki yanlış bilgiyi, eksik kaynağı veya sonraki üretken modelin hatalı yanıtını kendiliğinden ortadan kaldırmaz.
LangChain içinde nasıl kullanılıyor?
LangChain’in resmi dokümantasyonunda langchain-typesafe paketi ve TypeSafeClassifier bileşeni bulunuyor. Bu bileşen bir Runnable olarak çağrılabiliyor ve diğer bileşenlerle birleştirilebiliyor. Güncel arayüzde durum verisi ile sorular birlikte invoke çağrısına gönderiliyor.
Entegrasyonun iki deneysel ara katmanı da var. ModelRouterMiddleware, bir talebi tanımlı model seçeneklerinden birine yönlendirebiliyor. AutoModeMiddleware, belirtilen araç çağrılarını risk açısından değerlendirip riskli bulduklarını çalıştırmadan hata sonucu döndürebiliyor. Bu ikinci bileşen kendi başına insan onayı istemiyor; onay akışı ayrıca kurulmalı.
Buradaki doğru ifade, “Jev’in LangChain ile entegrasyonu mevcut”tur. Bu, LangChain’in bütün kullanıcılarının Jev’i kullandığını veya modelin her agent çalışmasının zorunlu parçası olduğunu göstermez.
Kaynak: Jev is now available in LangSmith Evals
Örnek müşteri talebini sınıflandırmak:
Aşağıdaki örnek, resmi arayüz temel alınarak hazırlanmış bir entegrasyon taslağıdır. Canlı API çağrısıyla test edilmemiştir. langchain-typesafe paketinin kurulması ve TYPESAFE_API_KEY ortam değişkeninin tanımlanması gerekir.
from langchain_typesafe import Choice, TypeSafeClassifier
classifier = TypeSafeClassifier()
response = classifier.invoke({
    "state": {
        "message": "Bu ay iki kez ücret kesildi. Kontrol edebilir misiniz?"
    },
    "questions": {
        "team": Choice(
            instructions="Talebi uygun ekibe yönlendir.",
            criteria={
                "billing": "Fatura, ödeme ve ücretlendirme talepleri",
                "technical": "Teknik arızalar ve erişim sorunları",
                "other": "Diğer veya belirsiz talepler",
            },
        )
    },
})
answer = response.choices["team"]
print(answer.choice, answer.confidence)
Bu çağrı bir ekip seçimi üretir. CRM kaydını değiştirmek veya müşteriye yanıt göndermek ayrı uygulama adımlarıdır. Araya kurumun doğrulama, yetki ve onay kuralları eklenebilir.
LangGraph orkestrasyonuna nasıl bağlanır?
LangGraph’ta düğümler işlemleri, koşullu bağlantılar ise sıradaki adımı temsil eder. Karar modeli bir düğümde çağrılır; sonuç ortak duruma kaydedilir. Bir yönlendirme fonksiyonu bu sonucu iş kurallarıyla birleştirerek sonraki düğümü seçer.
Bu yazı için önerdiğimiz destek akışı şöyle kurulabilir:
1. Mesaj ve ilgili kayıtlar alınır; gereksiz kişisel veriler çıkarılır.
2. Karar modeli talep türünü ve eksik bilgi ihtiyacını değerlendirir.
3. Uygulama kodu değerlendirmeyi kurumun yönlendirme politikasıyla birleştirir.
4. Belirsiz veya kapsam dışı kayıt inceleme kuyruğuna aktarılır.
5. Uygun kayıt ilgili iş akışına yönlendirilir; gerekiyorsa üretken model yanıt taslağı hazırlar.
İnsan onayı gereken adımlar için LangGraph’ın interrupt() mekanizması kullanılabilir. Durumun korunması için bir checkpointer ve aynı işi tanımlayan thread_id gerekir. Onay geldiğinde akış sürdürülebilir. Yeniden başlatılan düğümün bazı kodları tekrar çalışabileceği için dış sistemde değişiklik yapan işlemler tekrar yürütmeye dayanıklı tasarlanmalıdır.
Laya’yı aynı yapıda çalıştırmak
Laya SDK’sı bir Python fonksiyonunun içinde çağrılıp LangGraph düğümüne yerleştirilebilir. Bir başka seçenek, modeli kurum içinde çalışan bir servise alıp düğümden bu servisi çağırmaktır. Bu, önerilen bir entegrasyon tasarımıdır; hazır bir resmi Laya–LangChain bağlayıcısı kullandığımız anlamına gelmez.
Laya’nın belgelenen çağrı biçimi aşağıdaki gibidir. state ve questions, uygulamanın hazırladığı girdilerdir.
from laya import Router
# Servis başlangıcında yüklenir; her istek için yeniden oluşturulmaz.
router = Router(preload=True)
result = router.predict(state, questions)
answers = result["answers"]
Türkçe taleplerde İngilizce kök modelin yeterli olduğu varsayılmamalıdır. Çok dilli varyant, gerçek Türkçe kayıtlar ve kuruma özgü terimlerle sınanmalıdır. Yerel dağıtımın avantajı veriyi kurumun ortamında tutabilmesidir; karşılığında donanım ve servis yönetimi sorumluluğu üstlenilir.
Hangi iş yüklerinde anlamlı olabilir?
Aşağıdakiler doğrulanmış müşteri uygulamaları değil, bu arayüzlerle kurulabilecek örnek mimarilerdir.
Talep sınıflandırma: Destek kayıtları ekiplere ayrılabilir, eksik bilgi içerenler ayrı kuyruğa alınabilir. Beklenen fayda, her kayıt için uzun bir üretken model çağrısına ihtiyaç duymadan ilk ayrıştırmayı yapabilmektir.
RAG akışında kaynak değerlendirme: Getirilen belgelerin soruyla ilgili olup olmadığı veya yanıt için yeterli dayanak içerip içermediği değerlendirilebilir. Yetersiz bulunan kayıtlar yeni aramaya ya da incelemeye yönlendirilebilir. Bu kontrolün kendisi de yanlış karar verebileceği için kaynak doğruluğu ayrıca izlenmelidir.
Araç seçimi ve işlem öncesi değerlendirme: Tanımlı işlemler arasından seçim yapılabilir; önerilen işlemin hassasiyeti değerlendirilebilir. Ancak kullanıcı yetkisi, erişim kontrolü ve işlem limitleri deterministik uygulama kurallarıyla uygulanmalıdır.
Model yönlendirme: Kapsamı dar talepler daha düşük maliyetli bir modele, karmaşık talepler daha güçlü bir modele gönderilebilir. Kazanç ancak yönlendirme hataları ve ek karar çağrısının maliyeti birlikte ölçüldüğünde anlaşılır.
Performans ve maliyet nasıl değerlendirilmeli?
Lansman karşılaştırmalarını doğrudan kapasite planına çevirmek yanıltıcı olabilir. TypeSafe kendi değerlendirmelerindeki yüksek hız ve maliyet kazançlarının gerçek kullanımda görülebilecek kazanımların üst tarafında olabileceğini belirtiyor.
Laya da yayımladığı Jev karşılaştırmasında iki modelin aynı koşullarda doğrudan test edilmediğini, Jev sonuçlarının üçüncü taraf ölçümlerinden alındığını açıklıyor. Bu nedenle tek bir tabloda görülen hız farkını genel bir üstünlük olarak sunmak doğru olmaz.
Kurumsal pilotta aynı kayıtlar, aynı karar şemaları ve aynı kabul kriterleri kullanılmalıdır. Ortalama doğruluğa ek olarak yanlış yönlendirme oranı, incelemeye aktarılan kayıt oranı, p95 gecikme, zaman aşımı ve başarılı işlem başına toplam maliyet ölçülmelidir. Olasılık eşikleri de her görev için ayrı belirlenmelidir; destek kuyruğu seçimiyle kritik bir işlemi serbest bırakmanın hata maliyeti aynı değildir.
Açık ağırlıklı bir modelin yerel çalışması maliyetsiz olduğu anlamına gelmez. GPU veya CPU zamanı, bellek, izleme ve bakım giderleri hesaba katılmalıdır. API yaklaşımında ise istek maliyetinin yanında ağ gecikmesi, veri aktarımı ve servis bağımlılığı değerlendirilir.
Benchmark sonuçlarını birlikte okumak
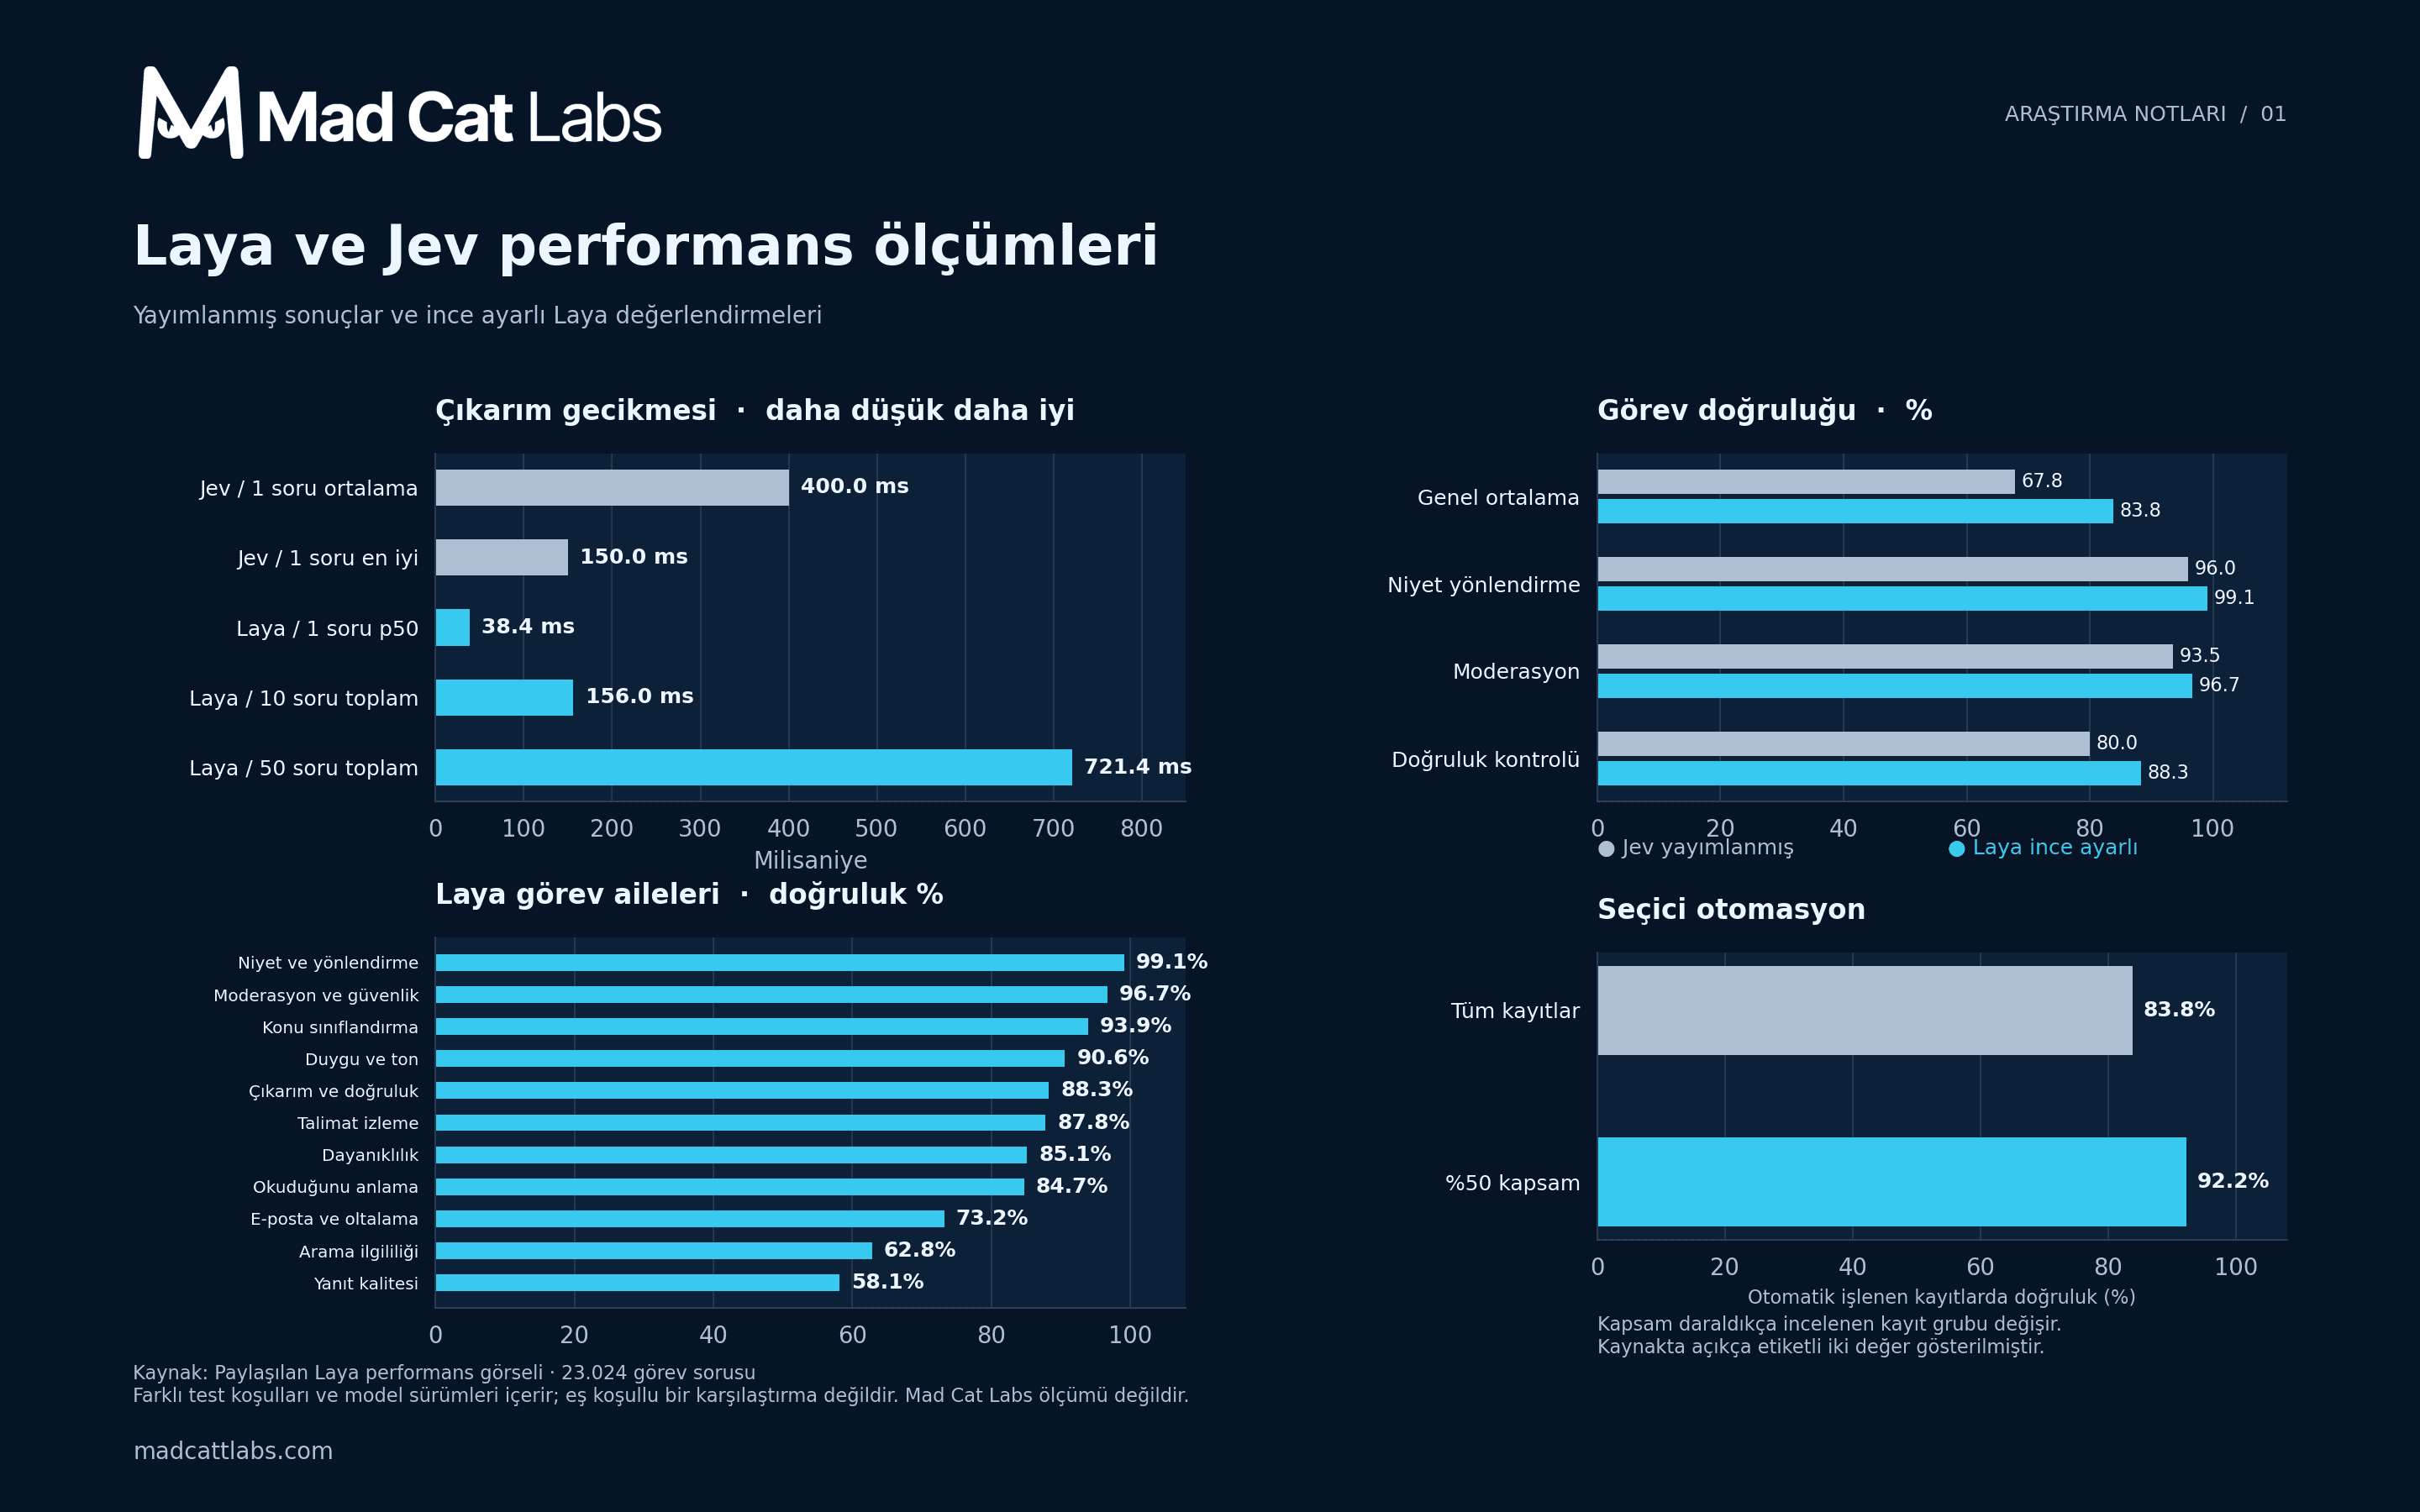
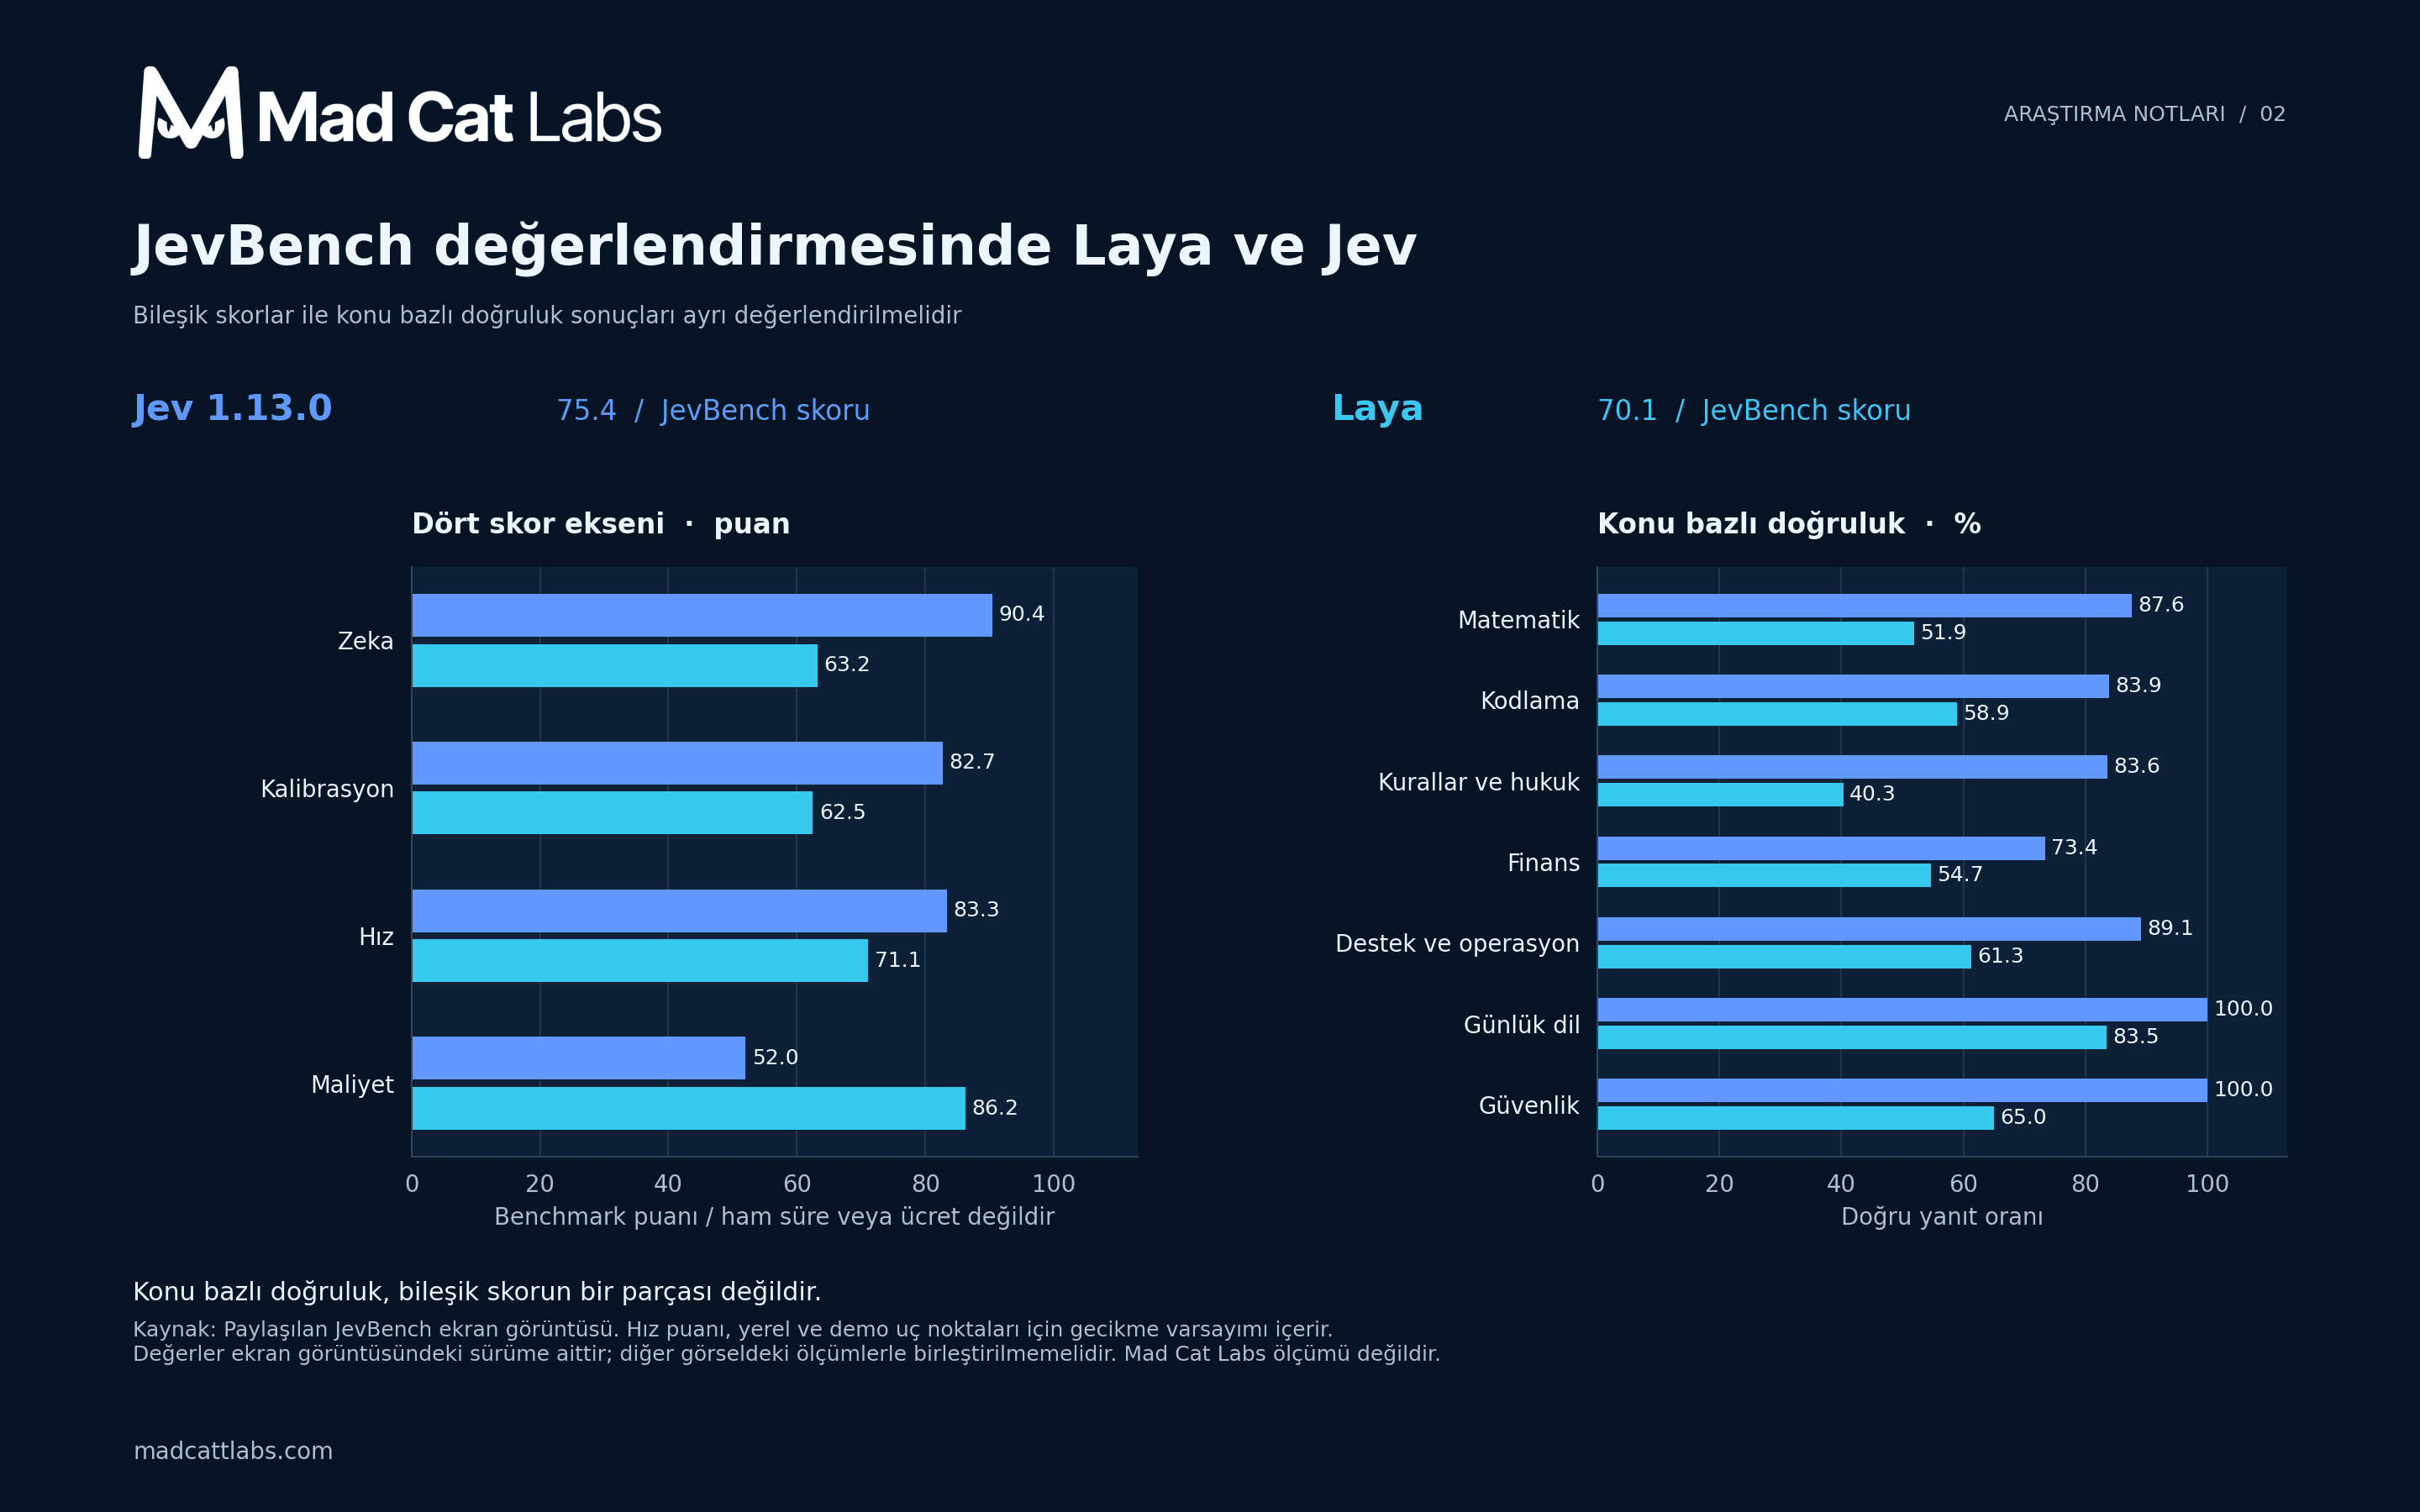
İki değerlendirme farklı sorulara yanıt veriyor. İlk görsel, yayımlanmış Jev sonuçlarını ince ayarlı Laya ölçümleriyle birlikte sunuyor. İkinci görsel, Jev 1.13.0 ve Laya için JevBench puanlarını ve konu bazlı doğruluk oranlarını gösteriyor. Test verisi, sürüm, uyarlama ve ölçüm yöntemleri aynı kabul edilmemelidir. Bu görseller Mad Cat Labs tarafından gerçekleştirilmiş testlerin sonuçları değildir.
Şekil 1 Yayımlanmış performans ölçümleri
İlk değerlendirmedeki seçici otomasyon sonucu, kayıtların yüzde 50’si otomatik işlendiğinde bu seçilmiş grupta yüzde 92,2 doğruluk bildiriyor. Bu, tüm kayıtların yüzde 92,2’sinin otomatik ve doğru işlendiği anlamına gelmez. Kapsam dışında kalan kayıtlar için ayrıca bir inceleme veya alternatif işlem yolu gerekir.
Şekil 2 JevBench skorları ve konu bazlı doğruluk
İkinci değerlendirmede maliyet ve hız eksenleri puandır; doğrudan ücret veya milisaniye değildir. Konu bazlı doğruluk da bileşik skordan ayrı sunulmuştur. Bu ayrımlar korunmadan grafiklerden kapasite veya bütçe tahmini çıkarmak yanıltıcı olabilir.
GitHub örneği ile karar döngüsünü görmek
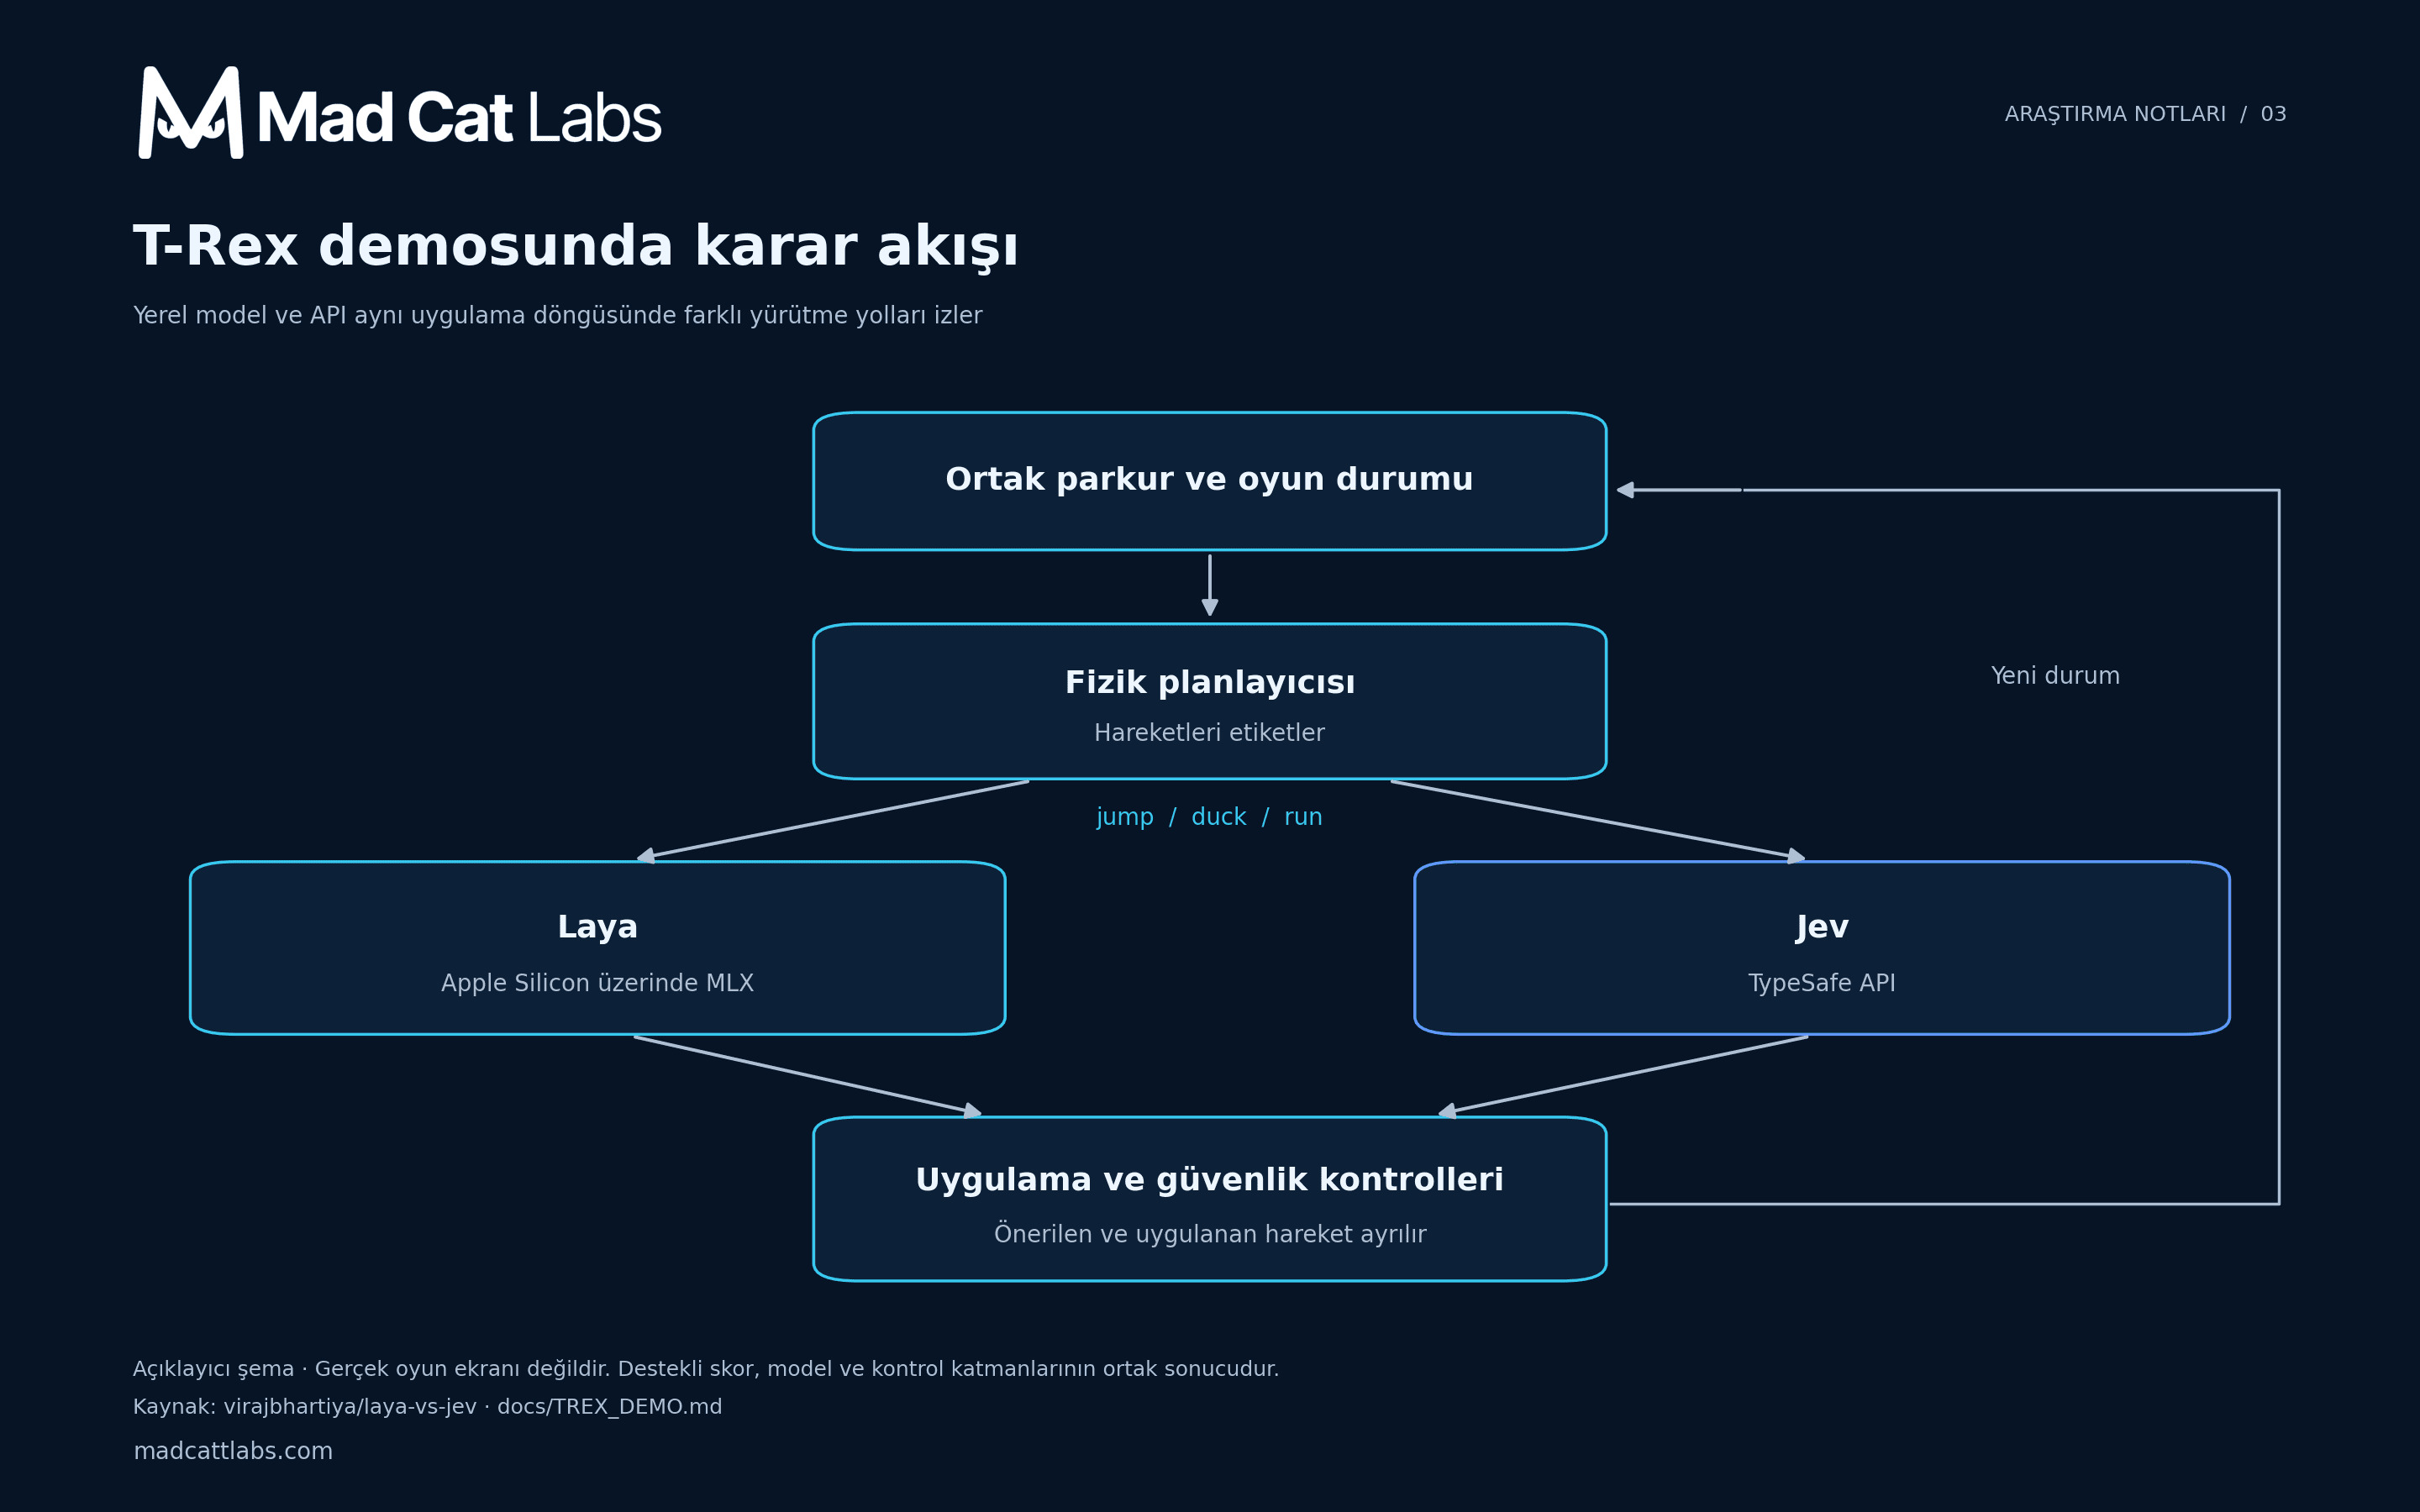
Viraj Bhartiya’nın laya-vs-jev projesi, iki karar modelini T-Rex oyununda yan yana çalıştırıyor. Laya, Apple Silicon üzerinde bağımsız MLX uyarlamasıyla yerel çalışırken Jev’e TypeSafe API üzerinden erişiliyor. Proje; seçimleri, yanıt sürelerini ve tekrar kayıtlarını görünür hale getiriyor. MLX uyarlaması resmi bir Convai Innovations sürümü değil.
Kaynak için: https://github.com/virajbhartiya/laya-vs-jev
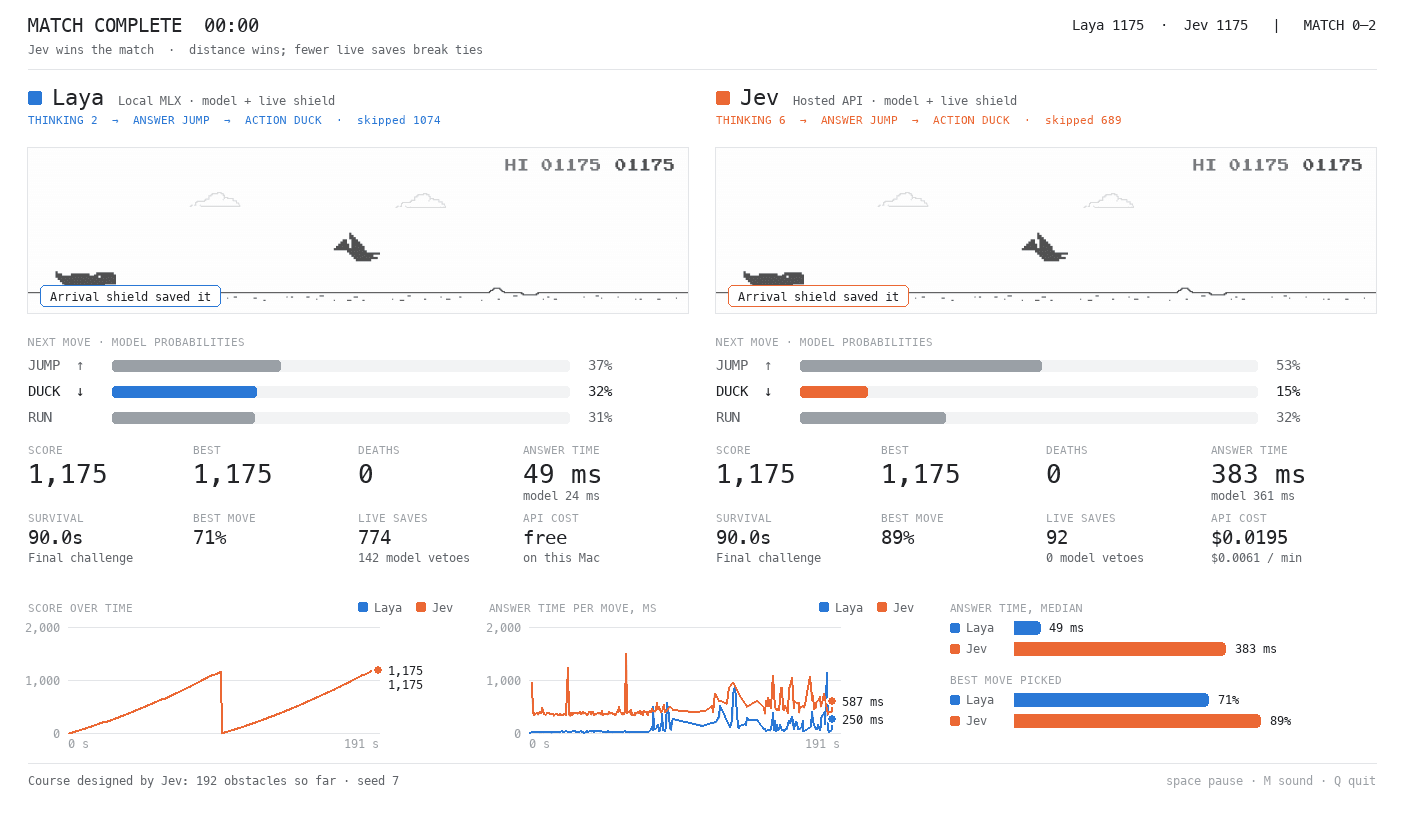
Modeller, fizik planlayıcısının etiketlediği hareketler arasından seçim yapıyor. Varsayılan güvenlik katmanları öneriyi değiştirebiliyor; gecikmiş kararlar da uygulama anında yeniden kontrol ediliyor. Bu nedenle hayatta kalma ve skor, modelin tek başına yeteneğini göstermiyor.
Şekil 3 T-Rex demosunun belgelerinden uyarlanan açıklayıcı karar akışı
21 Eylül 2026 tarihli destekli doğrulamada iki model de iki 90 saniyelik turu çarpışmadan tamamladı. Mesafeler eşitti; Jev, daha az canlı müdahale gerektirdiği için eşitlik kuralıyla kazandı. Rapor ayrıca 5,83 saniyelik ana sistem duraklaması bildiriyor. Bu sonuç temiz bir gecikme testi veya genel bir model sıralaması olarak okunmamalıdır.
Yerel çalışma süresini ayrı ölçmek
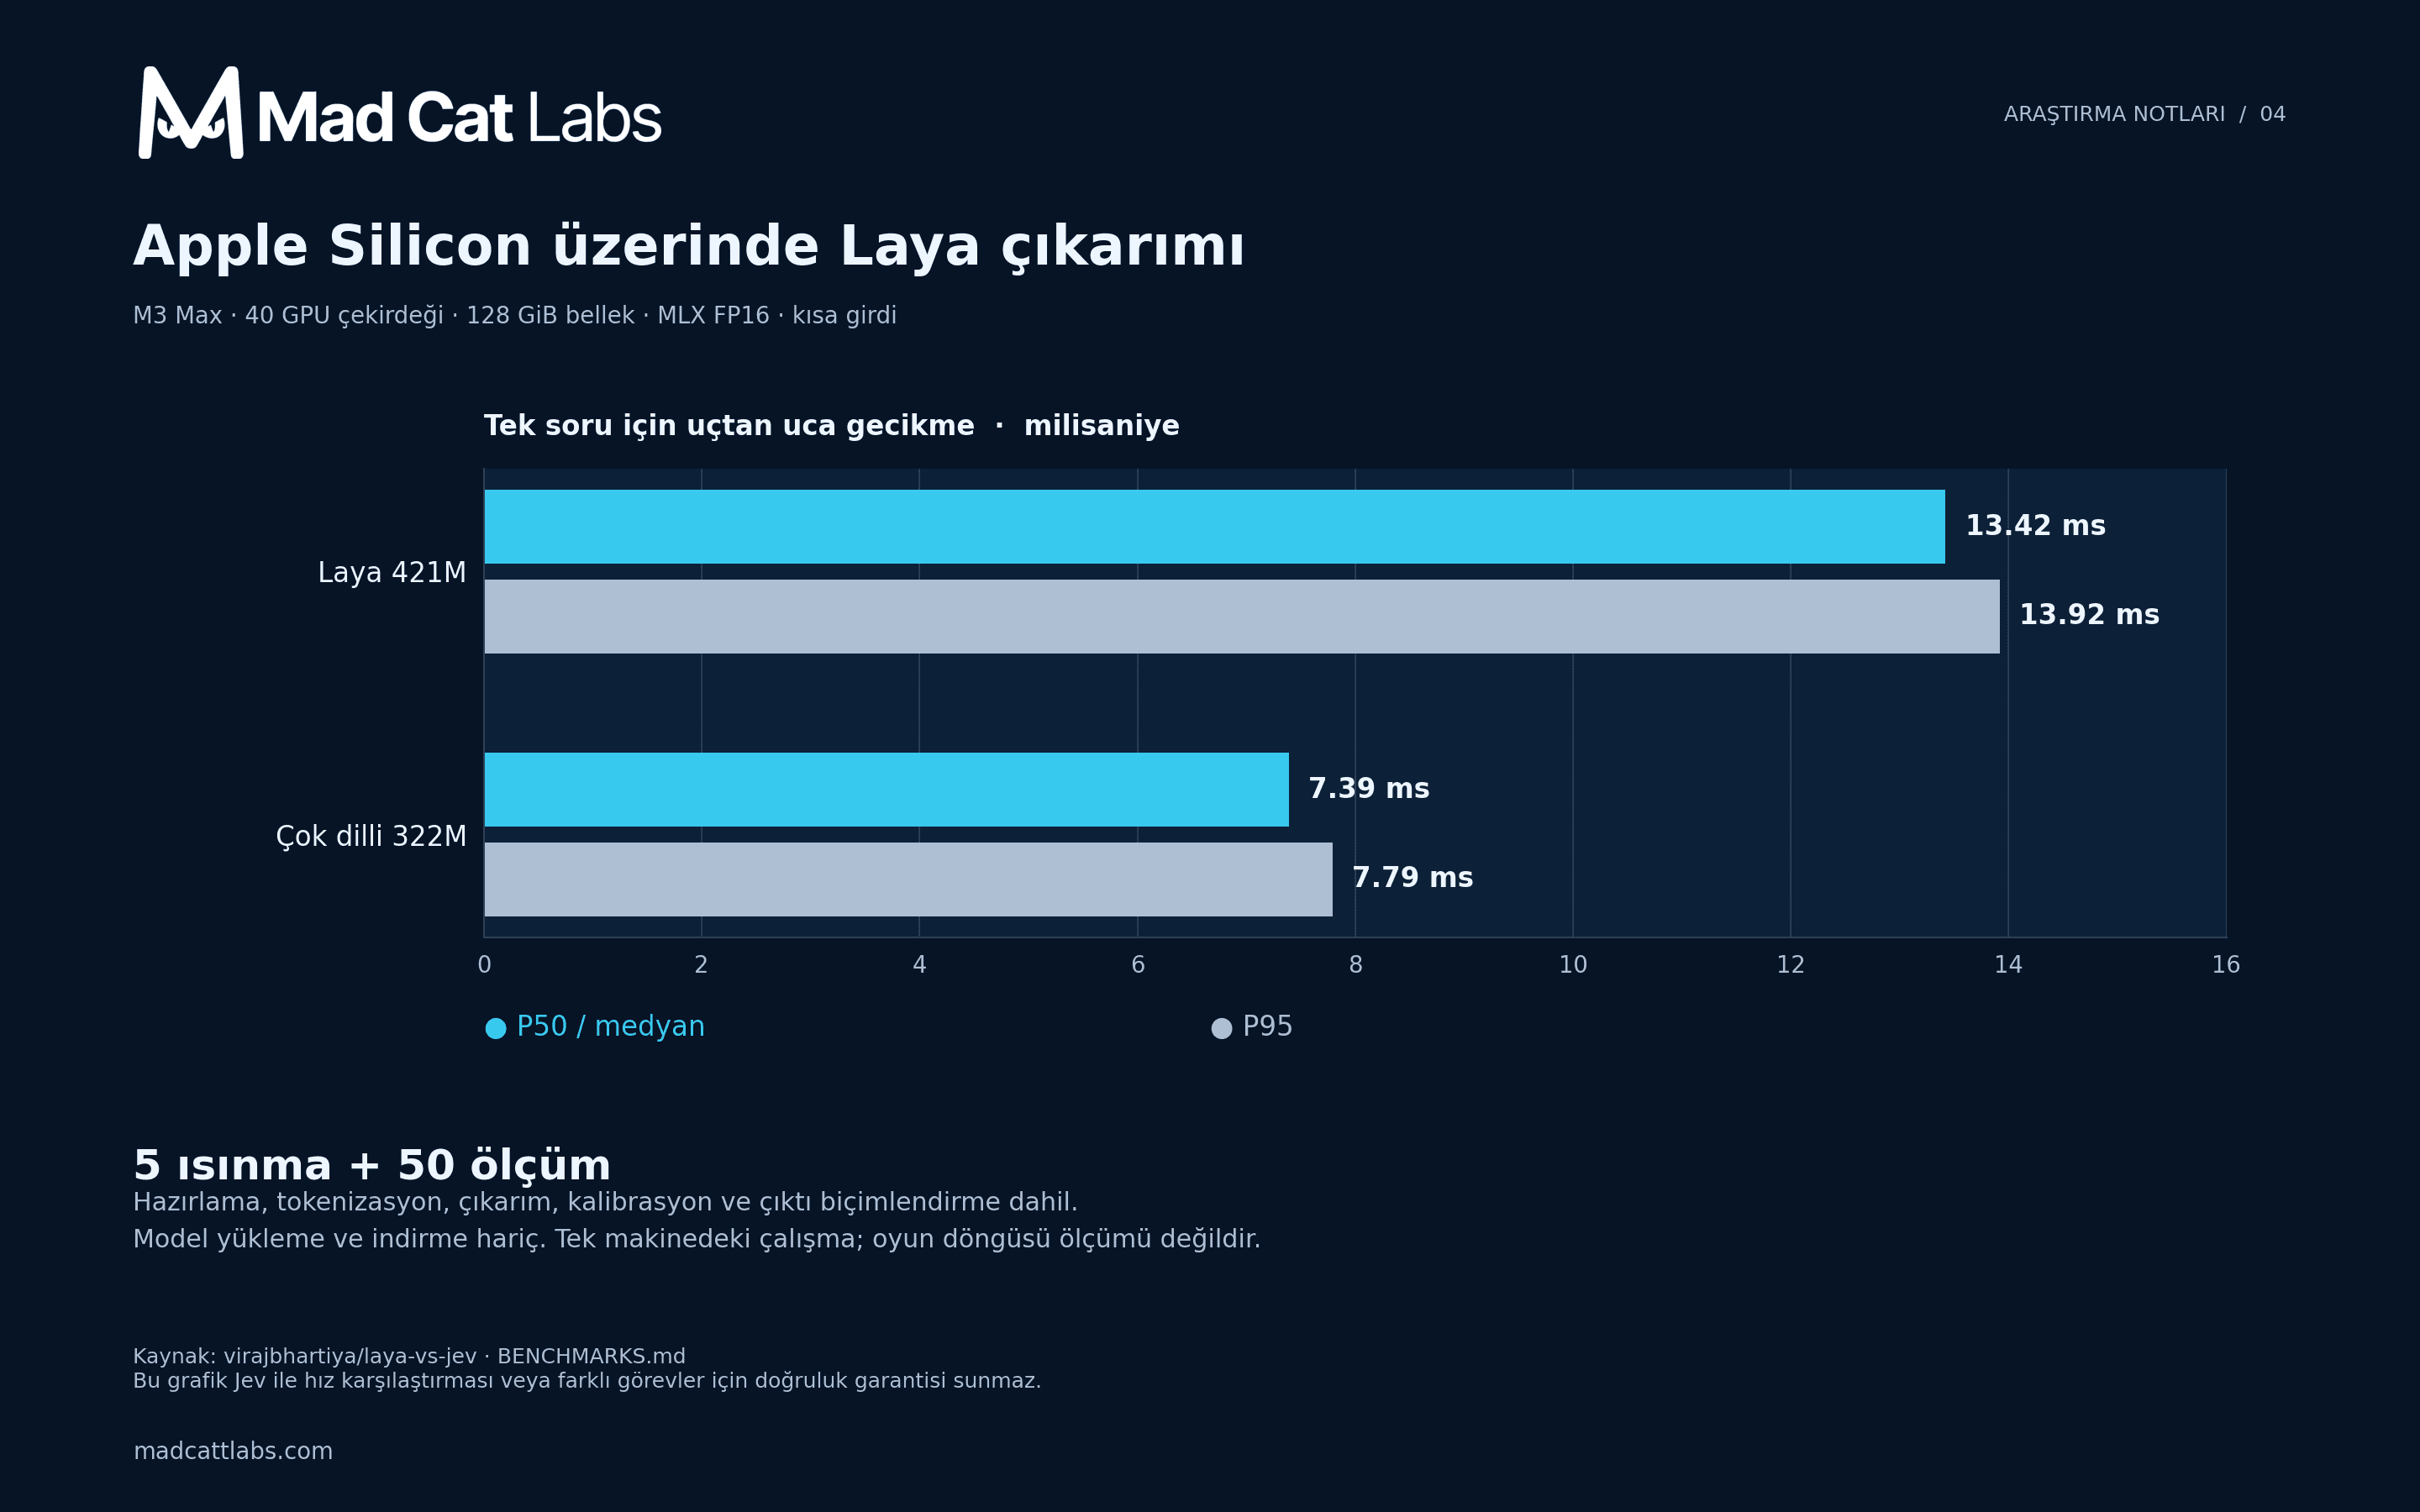
Repodaki MLX performans raporu, oyun gösteriminden ayrı bir testtir. M3 Max üzerinde kısa bir sorunun FP16 ölçümlerinde Laya 421M için 13,42 ms, çok dilli 322M için 7,39 ms medyan süre raporlanıyor. Aynı tablodaki P95 değerleri aşağıda verilmiştir. Bu çalışma burada yeniden çalıştırılmadı; sonuçlar geliştiricinin raporuna aittir.
Şekil 4 Yerel MLX ölçümleri ve test sınırları
Modeli yeni bir çalışma ortamına taşımak, karar doğruluğunu otomatik olarak artırmaz. Rapordaki kaynak uygulamayla uyum testleri, uyarlamanın seçili örneklerde aynı yanıtı verdiğini inceler; her görevde doğru yanıt verdiğini kanıtlamaz.
Kurumsal orkestrasyona çıkarılabilecek ders
Bu örnekten hareketle önerimiz, modelin önerisi ile uygulamanın gerçekleştirdiği işlemi ayrı kaydetmektir. Bir CRM kaydı değiştiğinde, eski veriye dayanarak üretilmiş karar doğrudan uygulanmamalıdır. Kararın hangi kayıt sürümüne ait olduğu kontrol edilebilir; koşullar değişmişse yeniden değerlendirme başlatılabilir.
Benzer biçimde toplam işlem süresi; veri hazırlama, model çağrısı, kuyruk ve dış sistem işlemleriyle birlikte ölçülmelidir. Böyle bir kayıt düzeni, iyileştirmenin model seçiminden mi, daha iyi zamanlamadan mı yoksa uygulama kurallarından mı geldiğini ayırt etmeyi sağlar.
Karar modelini üretime taşımak
Kurumsal entegrasyonda ilk adım, modelin değerlendireceği kararın kapsamını belirlemektir. Bir müşteri mesajından talep kategorisini çıkarmak ile ödeme iadesini onaylamak farklı sorumluluklar taşır. Model sınıflandırmayı yapabilir; işlemin gerçekleşmesi yetki, limit ve onay kurallarına bağlı olmalıdır.
Önerdiğimiz başlangıç yöntemi, modeli mevcut süreçle paralel çalıştırmaktır. İlk aşamada sonuçlar otomatik işlem başlatmaz; ekip kararlarıyla karşılaştırılır. Yanlış yönlendirmeler, incelemeye aktarılan kayıtlar, gecikme ve işlem başına toplam maliyet ölçülür. Otomasyon kapsamı bu sonuçlara göre genişletilir.
Kurumsal yapay zekada karar katmanını tasarlamak
Laya ve Jev, sınıflandırma ve yönlendirme gibi dar kararların ayrı bir bileşen olarak ele alınabileceğini gösteriyor. Üretken modelin yanıt hazırladığı, karar modelinin tanımlı soruları değerlendirdiği ve uygulama kodunun yetkileri uyguladığı bir mimari; her parçanın sorumluluğunu daha görünür hale getirebilir.
Mad Cat Labs olarak bu tür mimarileri model seçimi, donanım ve uygulama entegrasyonuyla birlikte değerlendiriyoruz. Kurumsal ölçekte belirleyici olan, karar modelini doğru noktaya yerleştirmek ve sağladığı katkıyı gerçek iş verisiyle ölçmektir.
Kurumunuza özel yapay zeka orkestrasyonu, yerel çıkarım ve entegrasyon çözümlerimiz için bizimle iletişime geçin.
madcatlabs.com · [email protected] · [email protected]